CI/CD i GitHub Actions od podstaw — pierwszy pipeline
CI/CD i GitHub Actions od podstaw: czym są CI i CD, jak wygląda pierwszy workflow z testami na pull request, jak trzymać sekrety i co dalej na ścieżce DevOps.
Zespół LearnIT
Krótka odpowiedź
CI (ciągła integracja) to automatyczne budowanie i testowanie kodu po każdej zmianie, a CD (ciągłe dostarczanie lub wdrażanie) to automatyczne przygotowanie albo wypuszczenie tej zmiany na środowisko. Na start zbuduj w GitHub Actions jeden prosty workflow: po otwarciu pull requesta pobiera kod, instaluje zależności, uruchamia linter i testy. Wdrożenie dodasz później.
Spis treści · 7
- 01Co to jest CI i CD prostymi słowy?
- 02Jak wygląda pierwszy workflow GitHub Actions na małym repo?
- 03Co powinno odpalać się na pull request, a co przy merge?
- 04Jak trzymać sekrety i nie commitować haseł?
- 05Kiedy dojść do Dockera i deployu, a czego nie robić na dniach 1–2?
- 06Jak ten skill łączy się z pełną ścieżką DevOps?
- 07Jakie błędy popełniają początkujący?
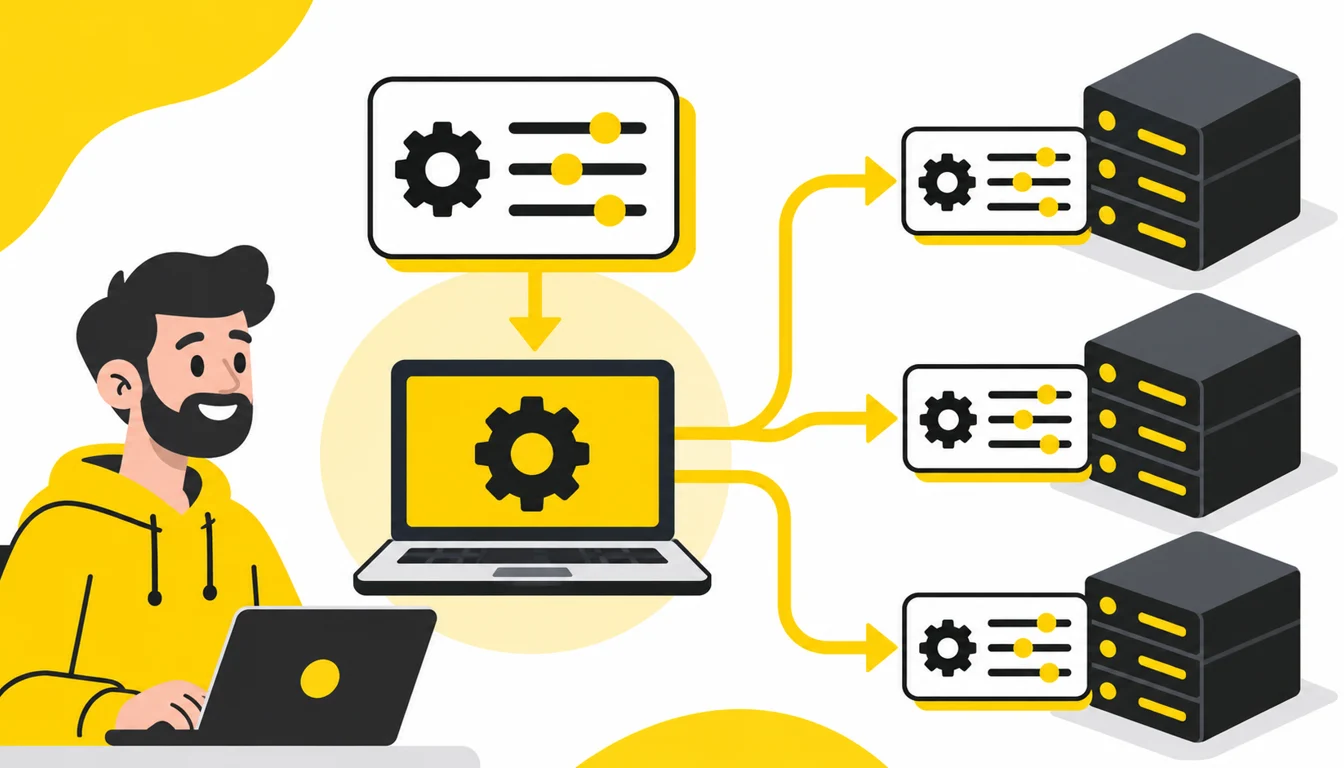
CI/CD to sposób pracy, w którym każda zmiana w kodzie jest automatycznie sprawdzana i — gdy przejdzie kontrole — przygotowywana do wdrożenia. CI (ciągła integracja) odpowiada za budowanie i testowanie, CD (ciągłe dostarczanie lub wdrażanie) za przekazanie zmiany dalej. Na początek zbuduj jeden prosty workflow w GitHub Actions: po otwarciu pull requesta pobiera kod, instaluje zależności i uruchamia linter oraz testy. Wdrożenie dodasz później.
Co to jest CI i CD prostymi słowy?
Wyobraź sobie zespół, w którym każdy wgrywa zmiany ręcznie, a ktoś raz na jakiś czas „skleja całość” i uruchamia testy. Efekt: błędy odkrywa się późno, a wdrożenie jest stresującym, ręcznym rytuałem, który zna tylko jedna osoba. CI/CD zamienia ten rytuał w automat.
- CI — Continuous Integration — po każdej zmianie system sam buduje projekt i uruchamia testy. Błąd widać w ciągu minut, gdy autor pamięta, co zmienił.
- Continuous Delivery — zmiana, która przeszła kontrole, jest zawsze gotowa do wdrożenia; decyzję „wypuszczamy” podejmuje człowiek jednym kliknięciem.
- Continuous Deployment — wdrożenie odbywa się automatycznie po przejściu wszystkich kontroli, bez ręcznego zatwierdzenia.
Skrót „CD” bywa rozwijany na dwa sposoby, więc przy czytaniu materiałów sprawdzaj, o który chodzi. Dla początkującego ważniejsze jest samo CI: nawet bez żadnego wdrożenia automatyczne testy po każdej zmianie zmieniają sposób pracy. Definicję samego pojęcia znajdziesz też w naszym słowniku IT.
Łańcuch kroków, który prowadzi od zmiany w kodzie do wdrożenia, nazywamy pipeline. Składa się z etapów, a każdy kolejny uruchamia się dopiero wtedy, gdy poprzedni zakończył się powodzeniem.
| Etap | Co się dzieje | Przykład na małym repozytorium | Kiedy uruchamiać |
|---|---|---|---|
| Pobranie kodu | system dostaje aktualną wersję repozytorium | krok pobierający kod gałęzi | zawsze |
| Linter | automatyczna kontrola stylu i prostych błędów | uruchomienie lintera dla języka projektu | pull request |
| Testy | sprawdzenie, czy kod działa zgodnie z oczekiwaniami | uruchomienie testów jednostkowych | pull request |
| Budowanie | przygotowanie wyniku do uruchomienia | zbudowanie obrazu lub paczki | pull request lub po scaleniu |
| Publikacja | zapis wyniku w miejscu, skąd można go pobrać | wysłanie obrazu do rejestru | po scaleniu |
| Wdrożenie | uruchomienie nowej wersji na środowisku | aktualizacja środowiska testowego | po scaleniu, najlepiej z zatwierdzeniem |
Jak wygląda pierwszy workflow GitHub Actions na małym repo?
GitHub Actions to mechanizm automatyzacji wbudowany w GitHub. Opisujesz go plikiem w formacie YAML, który leży w repozytorium, w katalogu .github/workflows. Dlaczego akurat on na start? Bo działa tam, gdzie i tak trzymasz kod, i nie wymaga stawiania własnego serwera. Pojęcia, które poznasz — wyzwalacz, zadanie, krok, sekret — przenoszą się też na inne narzędzia, na przykład Jenkinsa, który zobaczysz w wielu firmach.
Poniżej przykład dla małego projektu w Pythonie. Zadanie uruchamia się na każdym pull requeście do głównej gałęzi:
name: Kontrola kodu

on:
  pull_request:
    branches: [main]

jobs:
  testy:
    runs-on: ubuntu-latest
    steps:
      - name: Pobranie kodu
        uses: actions/checkout@v4

      - name: Instalacja Pythona
        uses: actions/setup-python@v5
        with:
          python-version: "3.12"

      - name: Instalacja zależności
        run: pip install -r requirements.txt ruff pytest

      - name: Linter
        run: ruff check .

      - name: Testy
        run: pytest
Numery wersji akcji i Pythona w przykładzie traktuj jako ilustrację — aktualne wartości sprawdź w dokumentacji GitHub Actions, bo zmieniają się z czasem. Linter i testy dobierz do swojego projektu; schemat jest ten sam niezależnie od języka.
Co tu jest najważniejsze? Sekcja on mówi, kiedy workflow się uruchamia. Sekcja jobs zawiera zadania, a każde z nich składa się z kroków wykonywanych po kolei na świeżej maszynie. Jeśli którykolwiek krok zakończy się błędem, całe zadanie jest czerwone, a pull request pokazuje to wprost. Świeża maszyna ma jeszcze jedną zaletę: wymusza, żeby wszystko, czego projekt potrzebuje, było opisane w repozytorium. Hasło „u mnie działa” przestaje wtedy obowiązywać.
Siedem kroków do pierwszego działającego pipeline:
- Utwórz małe repozytorium z prostym projektem, kilkoma testami i plikiem requirements.txt z zależnościami projektu (może być pusty). Ruff i pytest instaluje sam workflow, więc nie musisz ich dopisywać do tego pliku.
- Dodaj katalog .github/workflows i w nim plik workflow z wyzwalaczem na pull request.
- Opisz w pliku zadanie, które pobiera kod, instaluje zależności i uruchamia testy oraz linter.
- Wypchnij gałąź, otwórz pull request i sprawdź wynik uruchomienia w zakładce Actions.
- Zepsuj celowo jeden test, zobacz czerwony wynik, popraw kod i sprawdź, że kontrola przechodzi.
- Włącz w ustawieniach repozytorium wymaganie przejścia kontroli przed scaleniem zmian.
- Opisz w README, co uruchamia się na pull request, a co po scaleniu, i gdzie trzymasz sekrety.
Piąty krok jest ważniejszy, niż się wydaje. Dopóki nie zobaczysz czerwonego wyniku, nie masz pewności, że kontrola naprawdę coś sprawdza. Pipeline, który nigdy nie zawodzi, bywa po prostu pustym pipeline.
Co powinno odpalać się na pull request, a co przy merge?
Zasada praktyczna: na pull request uruchamiaj to, co jest szybkie i mówi, czy zmianę można scalić. Przy scaleniu do głównej gałęzi uruchamiaj to, co ma skutek poza repozytorium: publikację wyników i wdrożenie.
| Zdarzenie | Co uruchomić | Dlaczego |
|---|---|---|
| Pull request | linter, testy, ewentualnie budowanie | szybka informacja zwrotna dla autora i recenzenta |
| Scalenie do głównej gałęzi | budowanie, publikacja, wdrożenie na środowisko testowe | wynik pochodzi z kodu, który został zatwierdzony |
| Znacznik wersji | przygotowanie wydania | wydanie jest powtarzalne i powiązane z konkretną wersją kodu |
| Harmonogram | dłuższe kontrole, np. przegląd zależności | kontrole, które nie muszą blokować każdej zmiany |
Warto też ustawić w repozytorium wymaganie, by przed scaleniem kontrola przeszła na zielono. Bez tego pipeline jest tylko sugestią; z tym — realnym zabezpieczeniem. Chodzi o to, żeby zielony wynik naprawdę znaczył „można scalać”.
Wolisz uczyć się w ustalonej kolejności?
Sprawdź kurs DevOps w LearnIT — program, projekty i feedback do kodu.
Zobacz programJak trzymać sekrety i nie commitować haseł?
Gdy pipeline zaczyna łączyć się z czymś na zewnątrz — rejestrem obrazów, chmurą, serwerem — potrzebuje kluczy dostępu. Najczęstszy błąd początkujących to wpisanie takiego klucza prosto do pliku workflow albo do kodu. Repozytorium ma historię, więc nawet usunięty później klucz zostaje w starych wersjach plików. Klucz, który choć raz trafił do repozytorium, uznaj za ujawniony i unieważnij go, zamiast tylko usuwać z pliku.
Platforma ma do tego osobny mechanizm: sekrety przechowywane w ustawieniach repozytorium lub środowiska i odczytywane w workflow przez specjalne odwołanie. Ich wartości nie są wyświetlane w logach, ale to nie znaczy, że można z nimi robić cokolwiek — pilnuj, żeby kod nie wypisywał ich do konsoli.
- Żadnych haseł, tokenów i kluczy w plikach repozytorium ani w workflow.
- Sekrety trzymasz w mechanizmie sekretów platformy, osobno dla każdego środowiska.
- Każdy klucz ma minimalne uprawnienia potrzebne do jednego zadania.
- Workflow z dostępem do sekretów uruchamia się tylko na zaufanych zdarzeniach, a nie na każdej zmianie z cudzego forka.
- W pliku
.gitignoresą pliki lokalnej konfiguracji i pliki z danymi dostępowymi. - Gałąź główna jest chroniona: scalenie wymaga przejścia kontroli i recenzji.
- Akcje z zewnątrz wybierasz ostrożnie i przypinasz do konkretnej wersji, a zależności aktualizujesz świadomie.
- Po ujawnieniu klucza unieważniasz go natychmiast, a dopiero potem sprzątasz repozytorium.
Szerszy temat kontroli bezpieczeństwa w pipeline rozwijamy w tekście DevSecOps — bezpieczeństwo w pipeline.
Kiedy dojść do Dockera i deployu, a czego nie robić na dniach 1–2?
Najczęstszy błąd to zbudowanie od razu pełnego łańcucha: obraz, rejestr, chmura, wdrożenie, powiadomienia. Efekt: pierwszy błąd w którymkolwiek elemencie zatrzymuje całość, a Ty nie wiesz, co jest przyczyną. Lepsza kolejność jest taka:
- Dni 1–2: repozytorium z kilkoma testami i workflow na pull request. Nic więcej.
- Kolejny krok: ochrona gałęzi głównej i wymóg zielonej kontroli przed scaleniem.
- Następnie: aplikacja w kontenerze i budowanie obrazu w pipeline. Najpierw zrozum sam kontener, potem go automatyzuj.
- Dalej: publikacja obrazu w rejestrze i wdrożenie na środowisko testowe, które nie jest produkcją.
- Na końcu: wdrożenie z ręcznym zatwierdzeniem, wycofywanie zmian i powiadomienia o wynikach.
Czego nie robić na początku: nie wdrażaj automatycznie na środowisko, z którego korzystają prawdziwi użytkownicy; nie rozbudowuj pliku workflow, dopóki nie rozumiesz każdej linii; nie kopiuj gotowych, długich konfiguracji z internetu bez przeczytania. Jeśli pracujesz z infrastrukturą opisaną kodem, zobacz też Terraform od podstaw, a o konfiguracji serwerów — Ansible od podstaw.
Jak ten skill łączy się z pełną ścieżką DevOps?
CI/CD jest „klejem” między resztą umiejętności. Żeby pipeline miał sens, potrzebujesz Gita i pracy na gałęziach, bo to od nich się zaczyna. Potrzebujesz Linuksa i terminala, bo zadania pipeline to w istocie polecenia powłoki. Dalej dochodzi Docker, bo środowisko uruchomieniowe warto opisać raz, i chmura, bo gdzieś trzeba wdrożyć. Do tego infrastruktura jako kod i konfiguracja serwerów, które sprawiają, że środowiska są powtarzalne.
Pełną kolejność nauki opisuje artykuł DevOps od podstaw — plan nauki, a przegląd tego, jak wybrać szkolenie, znajdziesz w tekście kurs DevOps — na co zwrócić uwagę. Gotowe pomysły na projekty, w których pipeline wygląda dobrze w portfolio, zebraliśmy w artykule projekty DevOps do portfolio.
Dobry projekt do portfolio na tym etapie jest mały: repozytorium z aplikacją, testami, workflow na pull request, opisem w README, co i kiedy się uruchamia, oraz uwagą o tym, jak zarządzasz sekretami. Taki zestaw pokazuje, że rozumiesz nie tylko składnię pliku YAML, ale też odpowiedzialność za to, co trafia na środowisko.
Jakie błędy popełniają początkujący?
Pierwszy to wdrażanie bez testów: pipeline, który tylko kopiuje pliki na serwer, jest skryptem do wdrożeń, a nie kontrolą jakości. Drugi to kontrole, które trwają kilkanaście minut — zespół zaczyna je omijać, więc wolne kroki przenoś na harmonogram lub scalenie. Trzeci to ignorowanie czerwonych wyników („to zawsze tak ma”); wtedy czerwony kolor przestaje coś znaczyć. Czwarty to brak ochrony gałęzi głównej i klucze w repozytorium. Piąty to zbyt duży start: jedno zadanie z trzema krokami, które rozumiesz, jest warte więcej niż rozbudowany plik skopiowany z internetu.
Chcesz uczyć się DevOps z prowadzącym i praktycznymi zadaniami? Sprawdź program kursu DevOps — w jego opisie pojawiają się między innymi Linux, Docker, CI/CD, AWS, Terraform i orkiestracja kontenerów. O zasadach ewentualnego wsparcia kosztów przeczytasz w opisie dofinansowania kursów IT — to informacja o zasadach, nie obietnica przyznania środków.
Chcesz nauczyć się DevOps?
Przejdź od teorii do praktyki pod okiem mentorów. Sprawdź kurs DevOps w LearnIT.
Zobacz kurs DevOps