Co to jest SRE (Site Reliability Engineering)?
SRE (Site Reliability Engineering) to podejście, w którym niezawodność systemów traktuje się jak problem inżynierski rozwiązywany kodem, a nie ręczną pracą operacyjną. Wyjaśniamy, czym SRE różni się od DevOps, czym są SLO, SLA i budżet błędów oraz dla kogo jest ta ścieżka.
Zespół LearnIT
Krótka odpowiedź
SRE (Site Reliability Engineering) to podejście inżynierskie, w którym niezawodność, dostępność i wydajność systemów traktuje się jak problem rozwiązywany kodem i automatyzacją, a nie ręczną obsługą. SRE definiuje mierzalne cele (SLO), monitoruje systemy, sprawnie reaguje na incydenty i eliminuje powtarzalną pracę. To konkretna, mierzalna implementacja idei DevOps — z budżetem błędów jako regułą decyzyjną.
Spis treści · 10
- 01Czym różni się SRE od DevOps?
- 02Co to są SLO, SLA i SLI?
- 03Na czym polega monitoring i obserwowalność?
- 04Rola automatyzacji i walka z toil
- 05Jak obie perspektywy patrzą na tę samą zmianę?
- 06Co mierzyć przed i po wdrożeniu?
- 07Jak reagować, gdy nowa wersja zawodzi?
- 08Kiedy budżet błędów zmienia decyzję?
- 09Dla kogo jest ścieżka SRE?
- 10Jak uczyć się wspólnych fundamentów?
SRE (Site Reliability Engineering) to dyscyplina inżynierska, w której zespół dba o niezawodność, dostępność i wydajność systemów, traktując te cele jak problemy do rozwiązania kodem i automatyzacją, a nie ręczną obsługą. Podejście powstało w Google i opiera się na mierzalnych celach (SLO), monitoringu, sprawnej reakcji na incydenty oraz stałym ograniczaniu powtarzalnej pracy. W skrócie: SRE łączy kompetencje programisty z odpowiedzialnością za działanie produkcji.
Wokół SRE narosło sporo mitów — że to „lepszy admin” albo po prostu inna nazwa DevOps. W praktyce to konkretny sposób myślenia o systemach: co jest wystarczająco niezawodne, jak to zmierzyć i kiedy warto zwolnić z nowymi funkcjami, żeby nie psuć stabilności. Poniżej rozkładamy to na części.
Czym różni się SRE od DevOps?
DevOps i SRE nie są dwiema nazwami tego samego stanowiska. DevOps opisuje sposób współpracy i automatyzacji dostarczania oprogramowania; SRE skupia się na mierzeniu niezawodności usługi i zarządzaniu kompromisem między zmianami a stabilnością. W jednym zespole te praktyki mogą się łączyć. Porównuj konkretne zadania: pipeline, monitoring, reakcję na incydent i decyzję o kolejnym wdrożeniu, a nie samą nazwę roli.
Najważniejsze różnice w skrócie:
- DevOps odpowiada na pytanie „jak dostarczać szybciej i bezpieczniej”, SRE — „jak utrzymać system wystarczająco niezawodnym w mierzalny sposób”.
- SRE definiuje twarde metryki (SLO, budżet błędów) i podejmuje na ich podstawie decyzje o tempie wdrożeń.
- SRE mocno stawia na eliminację tzw. toil — nudnej, powtarzalnej pracy operacyjnej, którą da się zautomatyzować.
Obie ścieżki korzystają z tych samych narzędzi. Jeśli dopiero zaczynasz i wahasz się między kierunkami, pomocne będą plan nauki DevOps od podstaw oraz przegląd Docker vs Kubernetes.
Co to są SLO, SLA i SLI?
To fundament pracy SRE, bo bez liczb „niezawodność” jest tylko wrażeniem. Trzy pojęcia, które trzeba rozdzielić:
- SLI (Service Level Indicator) — konkretna metryka, np. procent udanych żądań albo czas odpowiedzi.
- SLO (Service Level Objective) — wewnętrzny cel dla tej metryki, np. „99,9% żądań w miesiącu zakończonych sukcesem”.
- SLA (Service Level Agreement) — formalna umowa z klientem, zwykle z konsekwencjami finansowymi, gdy poziom usługi spadnie poniżej ustalonego progu.
Z SLO wynika kluczowe pojęcie: budżet błędów (error budget). Jeśli celujesz w 99,9% dostępności, pozostałe 0,1% to dopuszczalny margines awarii. Jak budżet zmienia decyzję o kolejnym wdrożeniu, pokazujemy niżej na przykładzie jednej zmiany.
Na czym polega monitoring i obserwowalność?
SRE nie da się uprawiać „na czuja”. Potrzebujesz danych, które pokazują, co naprawdę dzieje się w systemie, zanim zauważy to użytkownik. Mówimy tu o trzech filarach obserwowalności:
- Metryki — liczbowe wskaźniki wydajności i dostępności (np. Prometheus, Grafana).
- Logi — zapisy zdarzeń przydatne przy analizie przyczyn.
- Tracing — śledzenie żądań przechodzących przez wiele usług, kluczowe w architekturze rozproszonej.
Dobrze zaprojektowany monitoring alarmuje o rzeczach, które faktycznie dotykają użytkownika, a nie o każdym drobiazgu. Nadmiar fałszywych alertów prowadzi do „zmęczenia alarmami” i przeoczenia realnych problemów.
Rola automatyzacji i walka z toil
„Toil” to praca ręczna, powtarzalna, pozbawiona trwałej wartości i rosnąca wraz ze skalą systemu — restartowanie usług, ręczne wdrożenia, klikanie tych samych procedur. SRE dąży do tego, by takie zadania zamieniać w kod: skrypty, pipeline'y CI/CD, infrastrukturę jako kod (Terraform), automatyczne skalowanie.
To właśnie dlatego SRE potrzebuje solidnych umiejętności programistycznych. Automatyzacja nie tylko oszczędza czas, ale też zmniejsza liczbę błędów ludzkich i uwalnia zespół na pracę, która realnie poprawia niezawodność. Fundamenty tych narzędzi — konteneryzacja, orkiestracja, chmura — pokrywają się z kursem DevOps.
Jak obie perspektywy patrzą na tę samą zmianę?
Wyobraź sobie usługę z nową wersją aplikacji. Z perspektywy praktyk DevOps zespół chce, aby zmiana przeszła testy i trafiła na środowisko w sposób powtarzalny, z możliwością cofnięcia. Z perspektywy SRE pyta dodatkowo, po czym pozna, że użytkownik nadal otrzymuje poprawną odpowiedź i czy tempo zmian pozostaje zgodne z przyjętym celem niezawodności. Nie oznacza to, że „DevOps nie dba o stabilność”, ani że „SRE nie wdraża”. Różni się akcent i zestaw reguł decyzyjnych.
Wolisz uczyć się w ustalonej kolejności?
Sprawdź kurs DevOps w LearnIT — program, projekty i feedback do kodu.
Zobacz programCo mierzyć przed i po wdrożeniu?
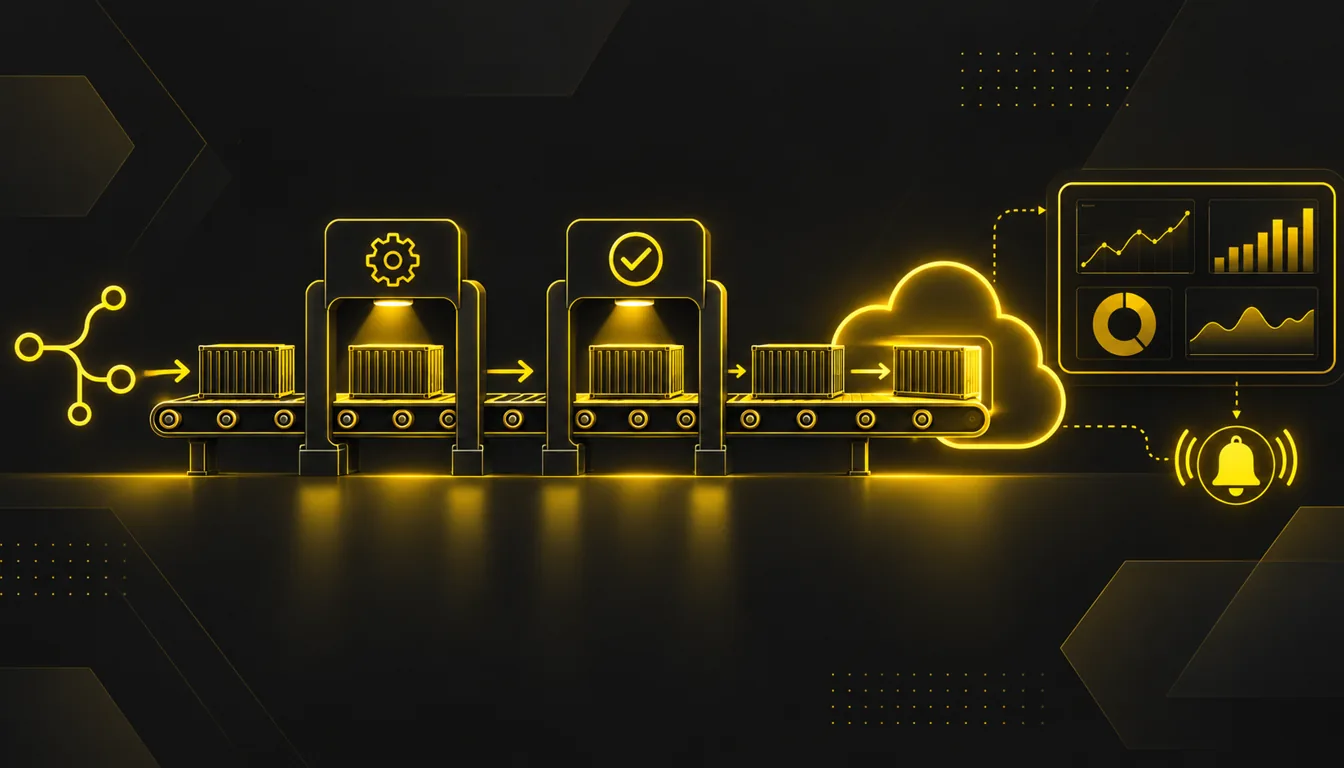
Wybierz sygnał odczuwalny dla użytkownika, na przykład udział poprawnych odpowiedzi albo czas odpowiedzi na krytyczne żądanie. Zdefiniuj, jakie żądania wchodzą do pomiaru i w jakim oknie analizujesz wynik. Pipeline może zablokować wdrożenie przy nieudanych testach; monitoring może ostrzec, że po wdrożeniu usługa działa gorzej. Sam wykres obciążenia CPU nie mówi jeszcze, czy użytkownik doświadcza błędu. O SLI, SLO i SLA piszemy wyżej — tutaj pojęcia służą do podjęcia decyzji w konkretnym przypadku, nie do powtórzenia słownika.
Jak reagować, gdy nowa wersja zawodzi?
Najpierw zidentyfikuj objaw i zakres wpływu, potem przywróć działanie: cofnij wdrożenie albo wyłącz wadliwą funkcję zgodnie z przygotowaną procedurą. Dokumentuj oś czasu i komunikuj status zainteresowanym osobom. Po odzyskaniu stabilności zbadaj przyczynę bez szukania winnego (blameless post-mortem); zaplanuj test, alert lub zmianę procedury, która ograniczy ryzyko powtórki. To wspólny grunt obu podejść: automatyzacja ma pomagać reagować bez improwizacji, a pomiar ma obejmować jakość usługi, nie tylko szybkość dostarczenia kodu.
Kiedy budżet błędów zmienia decyzję?
Budżet błędów to konsekwencja celu niezawodności w ustalonym oknie: mówi, ile odstępstwa od celu dopuszcza zespół. Nie jest zgodą na celowe psucie usługi. Jeśli zużycie rośnie, zespół może przełożyć ryzykowną zmianę i skoncentrować się na stabilizacji; jeśli dane są niewiarygodne, najpierw popraw pomiar. Żaden uniwersalny próg nie pasuje do wszystkich usług. Przed użyciem takiej reguły trzeba uzgodnić wskaźnik, okno, właścicieli decyzji i wyjątkowe sytuacje. Bez tego „budżet” staje się ozdobą prezentacji.
Dla kogo jest ścieżka SRE?
SRE dobrze pasuje osobom, które lubią jednocześnie programować i rozumieć, jak systemy zachowują się w produkcji. Najczęściej trafiają tu:
- administratorzy i DevOps engineerzy chcący pogłębić stronę inżynierską i pracę z metrykami,
- programiści, których ciągnie ku infrastrukturze, skalowaniu i niezawodności,
- osoby po przebranżowieniu do IT, które opanowały już podstawy Linuksa, sieci i chmury.
To raczej kierunek dla osób z pewnym doświadczeniem technicznym niż pierwszy krok w IT. Jeśli dopiero wybierasz ścieżkę, zajrzyj do poradnika jaki kurs IT wybrać.
Jak uczyć się wspólnych fundamentów?
Zacznij od usługi uruchamianej lokalnie, testu, pipeline'u oraz czytelnego logu. Potem dodaj jeden pomiar jakości i procedurę cofnięcia zmiany. W planie nauki DevOps opisano kolejność ćwiczeń, a aktualny kurs DevOps jest aktywną ofertą dotyczącą tych fundamentów; nie należy interpretować go jako kursu SRE ani gwarancji określonej roli. Warunki ewentualnego dofinansowania kursów IT są zależne od programu.
Zobacz też: ile zarabia się w IT.
Chcesz nauczyć się DevOps?
Przejdź od teorii do praktyki pod okiem mentorów. Sprawdź kurs DevOps w LearnIT.
Zobacz kurs DevOps